Smart-Kamera für Edge-Learning-OCR
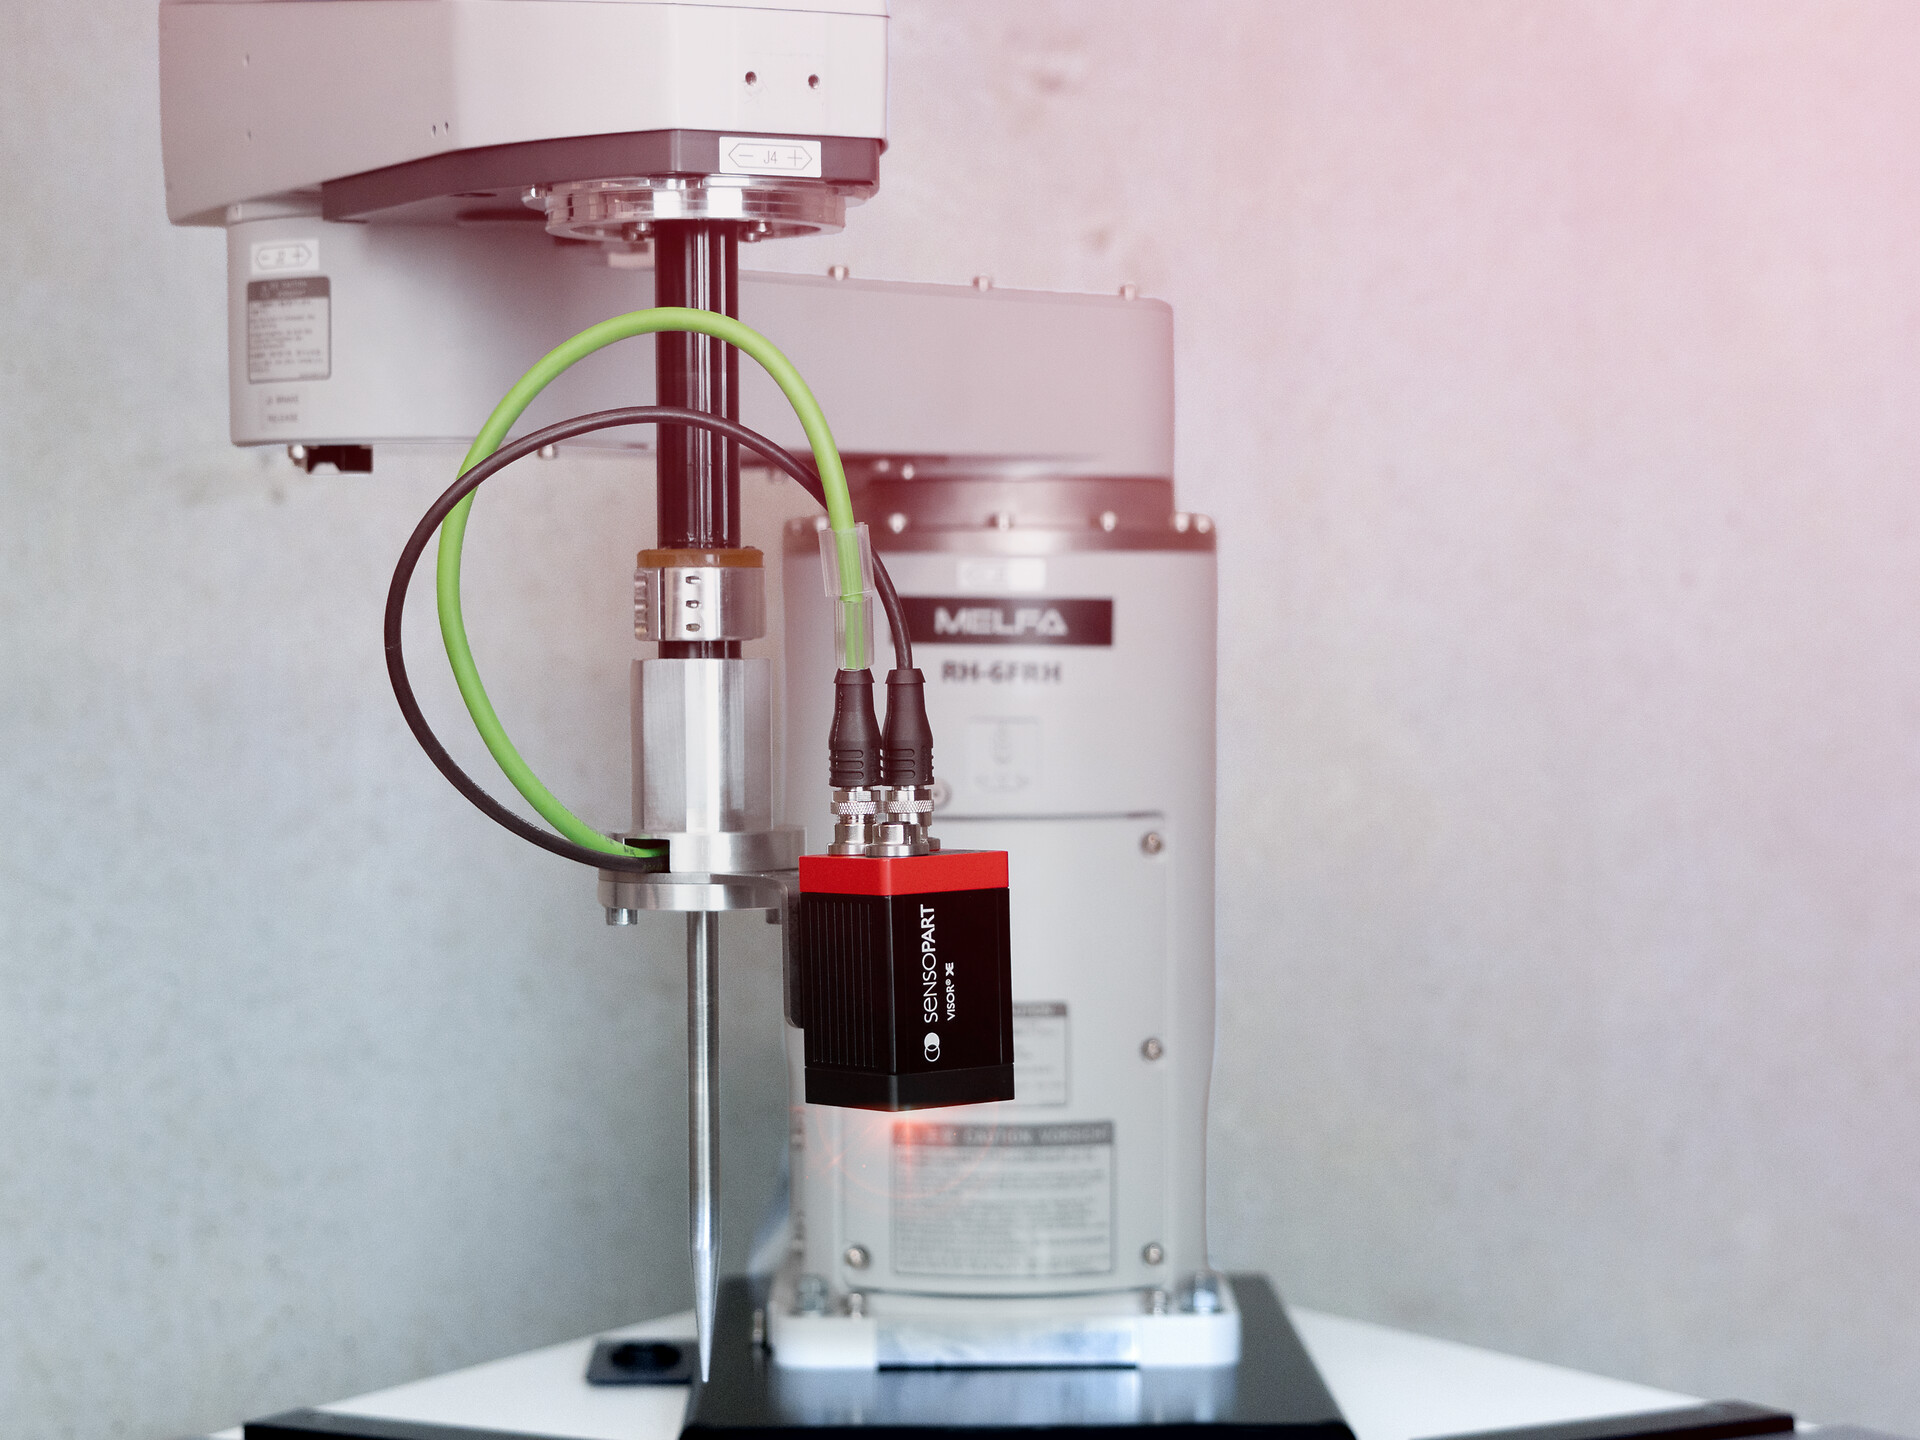
Die herausragende Geschwindigkeit und Genauigkeit von Edge-Learning-Tools wird dabei im besten Fall durch eine hochentwickelte Hardware wie dem Bildverarbeitungssystem In-Sight 3800 von Cognex gewährleistet. Diese Smart-Kamera verfügt über einen leistungsstarken Sensor, eine integrierte Beleuchtung, ein Autofokus-Flüssiglinsen-Objektiv für eine schnelle Fokussierung und hohe Geschwindigkeiten sowie einen integrierten Prozessor. Ihre HDR+-Funktion ermöglicht verkürzte Belichtungszeiten, wodurch sich Anwendungen mit schnelleren Liniengeschwindigkeiten realisieren lassen. Das kleine Gehäuse ist unempfindlich gegen Vibrationen. Die Kamera ist einfach zu platzieren, mit Strom zu versorgen und mit einer Fertigungs- bzw. Logistiklinie zu verbinden, um Bilder zu erzeugen, die perfekt für die Edge-Learning-OCR geeignet sind.
Trainingsaufwand reduziert
Herkömmliche regelbasierte OCR-Bildverarbeitungssysteme haben einen hohen Programmieraufwand bei der Einrichtung. Sie erfordern Zeit, Fachwissen und eine Neuprogrammierung, wenn sich die Anforderungen ändern. Im Gegensatz dazu werden Deep Learning-basierte Systeme trainiert, indem man ihnen spezifische, mit Tags versehene Bilder der entscheidenden Merkmale vorlegt. Deep Learning kann erstaunliche Fähigkeiten entwickeln, um feine Unterscheidungen zu treffen und Texte unter einer Vielzahl von schwierigen Bedingungen exakt zu lesen. Um diese Genauigkeit zu erreichen, können jedoch Hunderte oder sogar Tausende von markierten Bildern für das Training erforderlich sein. Git, CI/CD-Pipelines, automatisierte Builds, Code-Reviews im Team: in der Softwareentwicklung seit Jahren Standard, in der SPS-Programmierung bisher kaum umsetzbar. ‣ weiterlesen
SPS-Entwicklung trifft DevOps: Wie CODESYS 4 IT-Methoden in die Automatisierung bringt
Für die vortrainierte Edge-Learning-OCR reicht dagegen bereits eine kleine Zahl an Bildern zum spezifischen Anwendungsfall aus, um die Fähigkeit zu entwickeln, die gewünschten Schriften zu lesen. Für dieses spezifische Training der OCR ist zudem kein spezielles Wissen über Bildverarbeitung oder KI-Algorithmen erforderlich, sondern lediglich die Kenntnis der erforderlichen OCR-Aufgabe.
Einfache Implementierung
Auch in Bezug auf die Implementierung bieten Edge Learning-basierende OCR-Systeme Vorteile im Vergleich zu regelbasierten oder Deep-Learning-Bildverarbeitungssystemen. So sind damit weder unterschiedliche Schriftenbibliotheken noch detaillierte Analysen der möglichen Fehllesung verschiedener Symbole nötig. Herkömmliche OCR-Programme verwenden eine Reihe spezifischer Techniken, um die Gefahr der Fehllesung eines Symbols zu verringern, z.B. spezielle Schriftenbibliotheken oder eine Feldeinteilung, die eine sorgfältige Definition jeder möglichen Stelle in einem Code und die Festlegung des Typs erfordert, so dass z.B. die Ziffer 8 in einem definierten numerischen Feld nicht fälschlicherweise als ein ‚B‘ gelesen werden kann. Maschinen kommunizieren, reagieren und steuern Prozesse. Nur ihr Licht wird oft noch als passive Komponente behandelt. Dabei zeigen SPS-Anbindung, IO-Link und Signalfunktionen: Intelligentes Licht kann längst mehr als leuchten. ‣ weiterlesen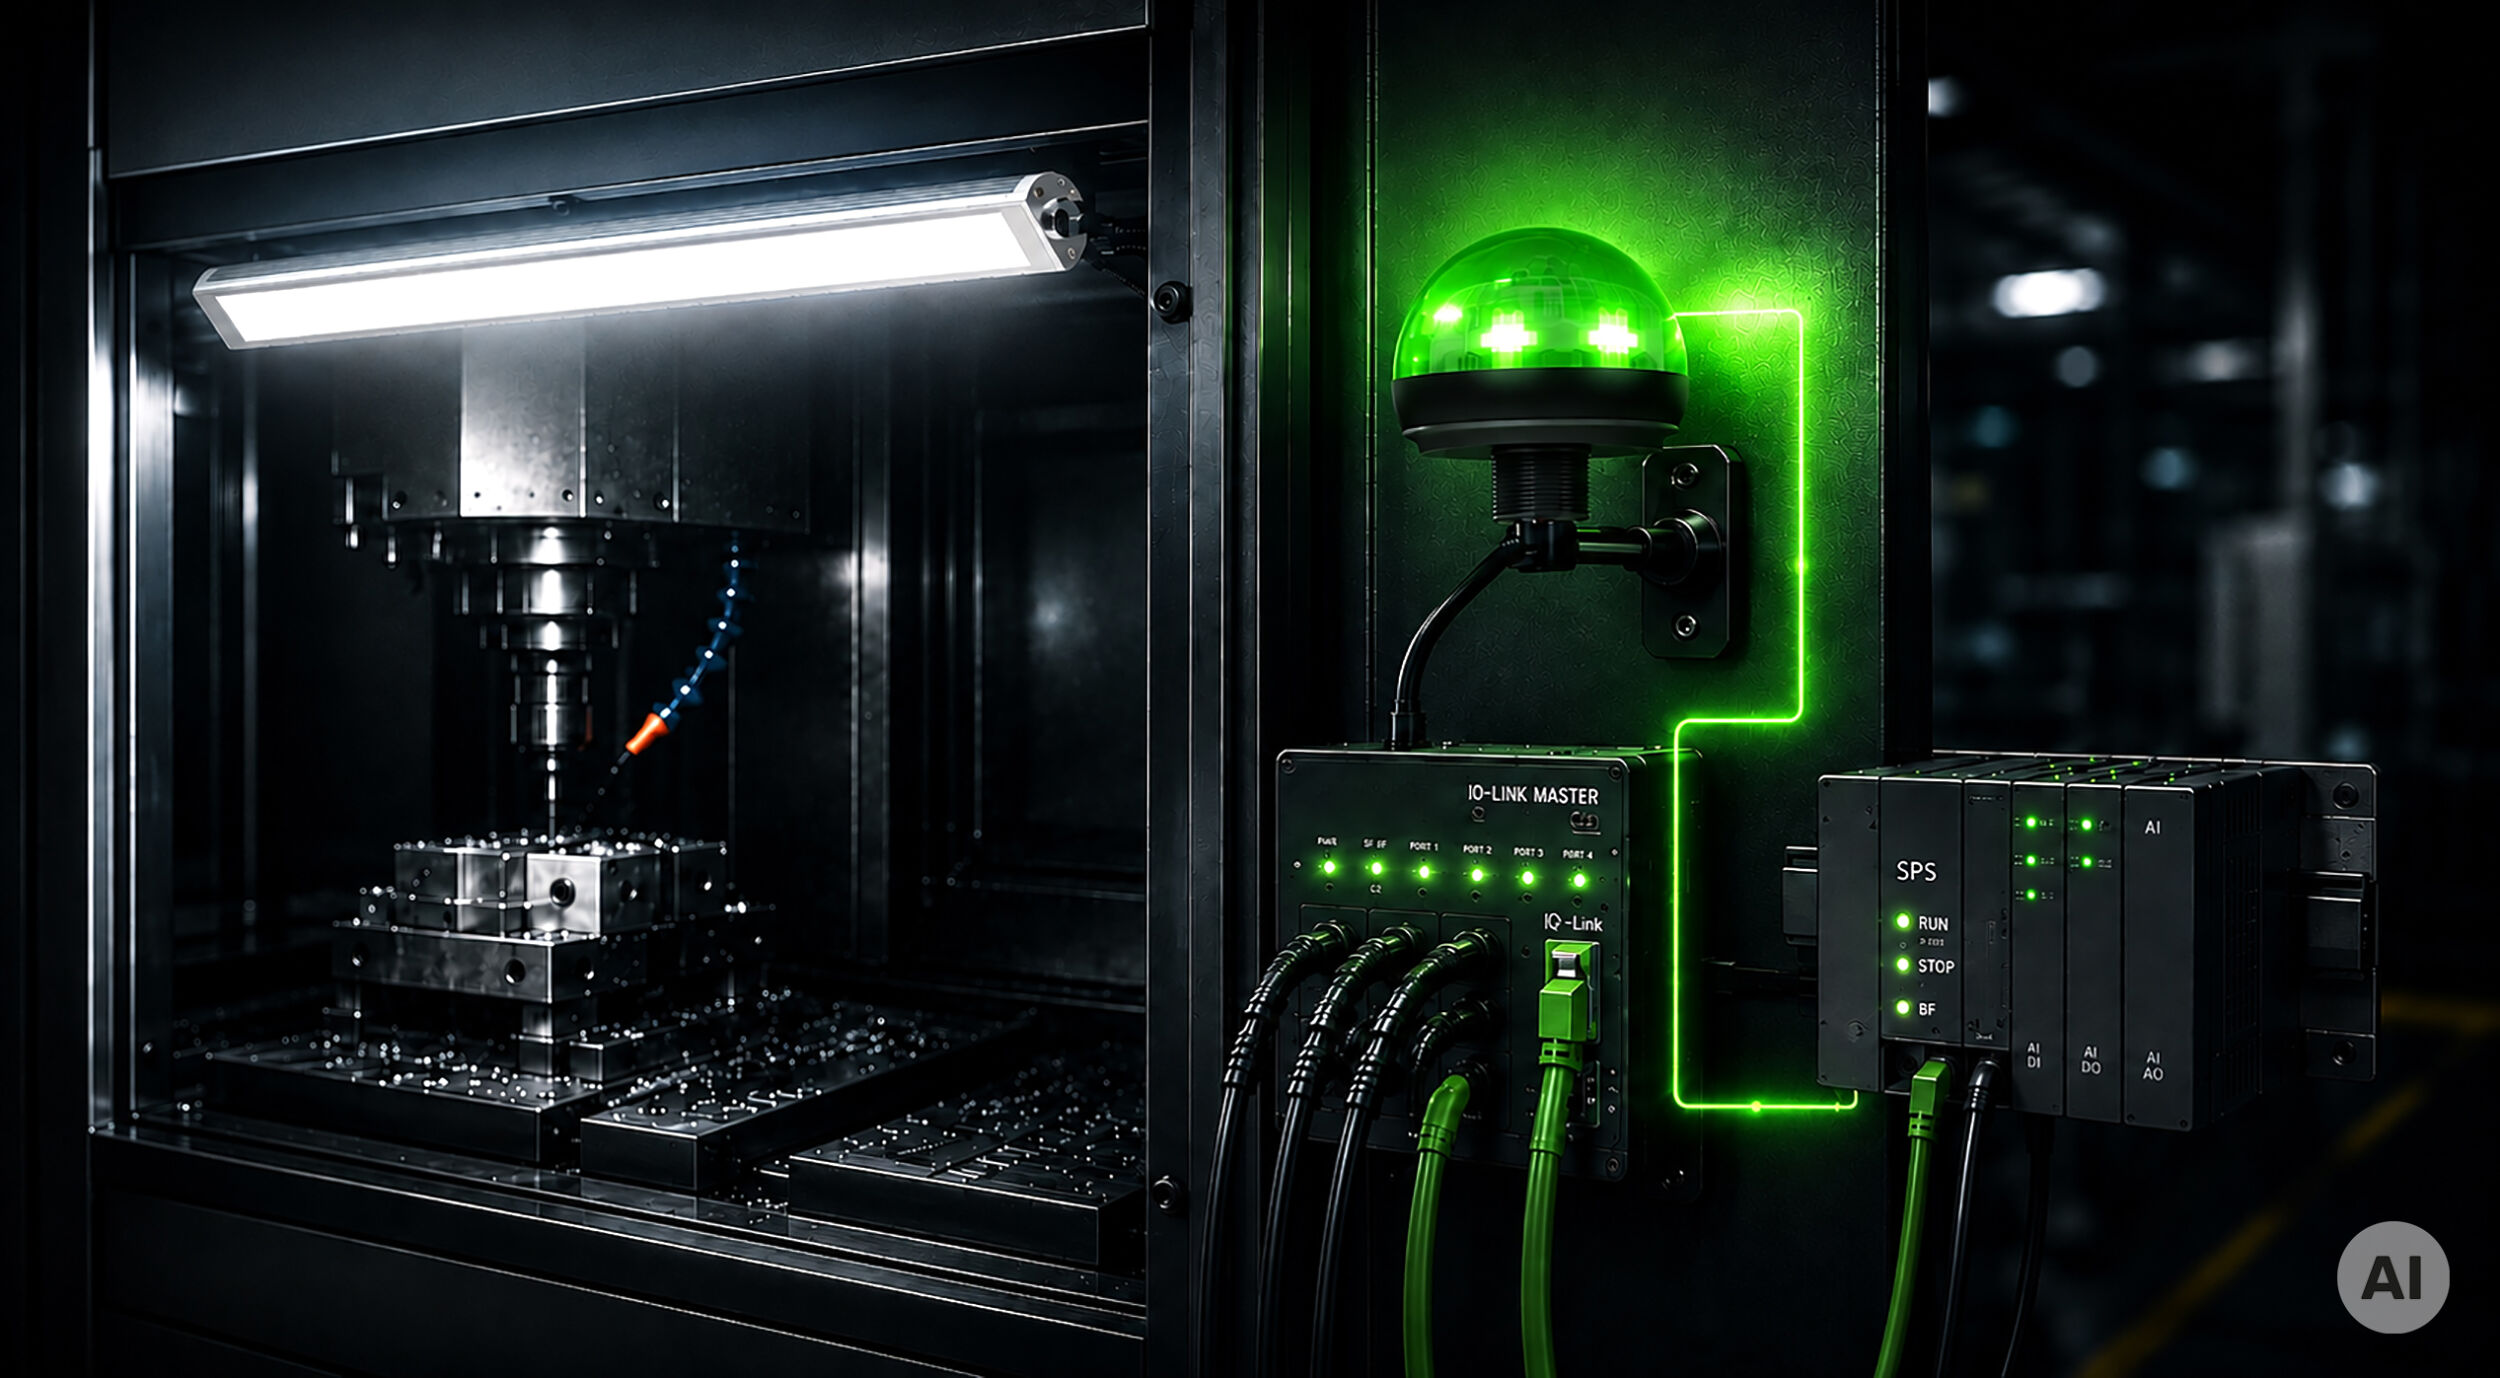
Wie intelligent ist Licht?